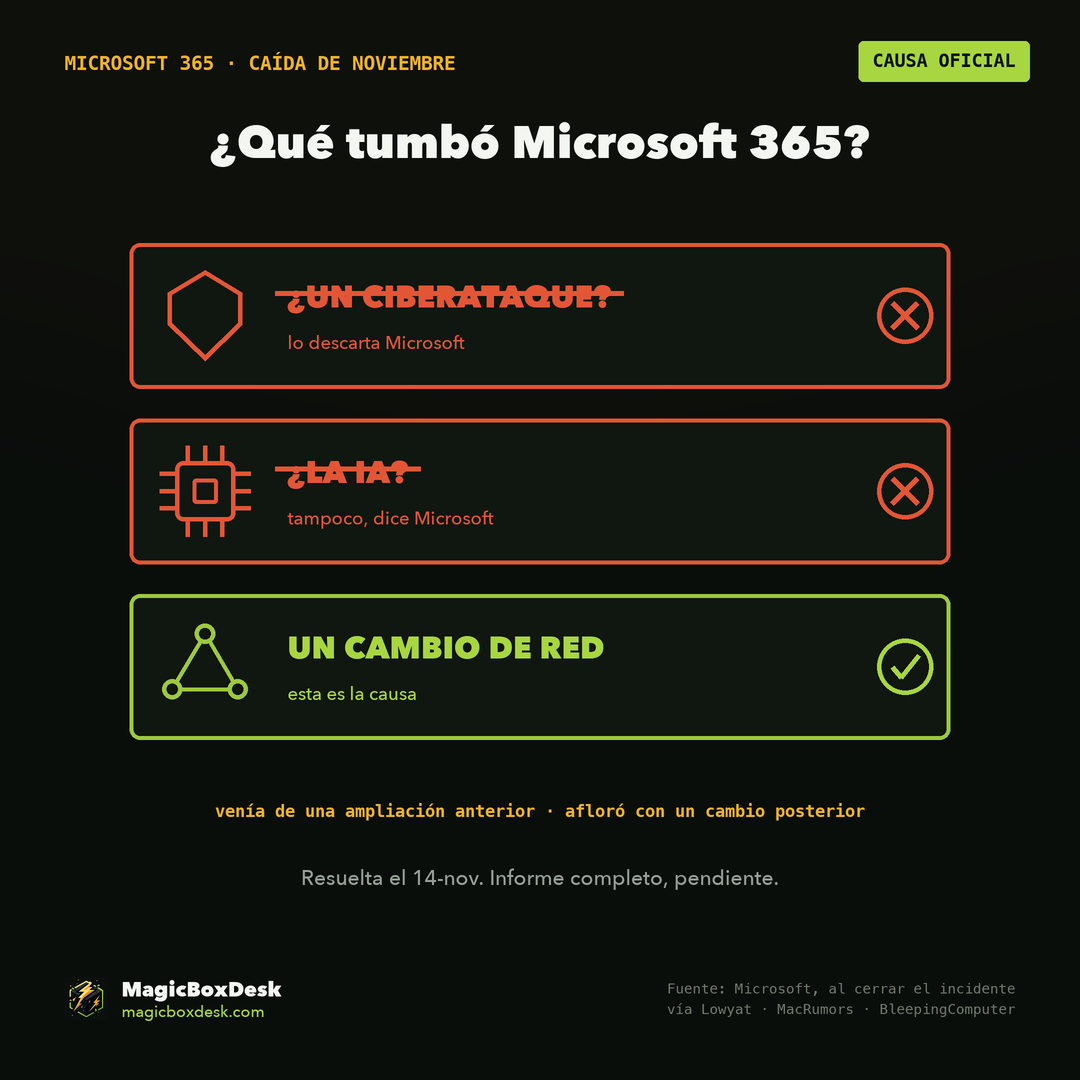
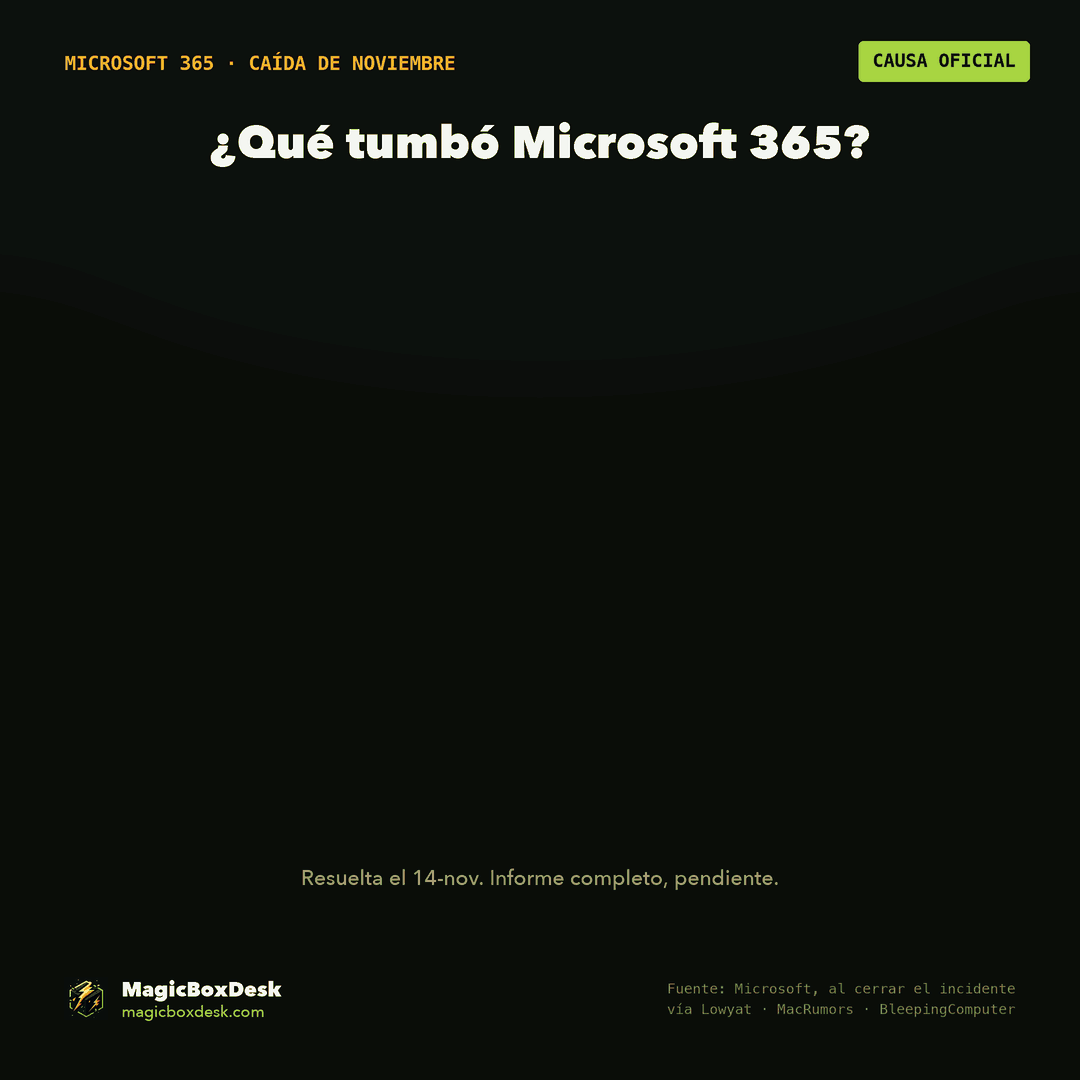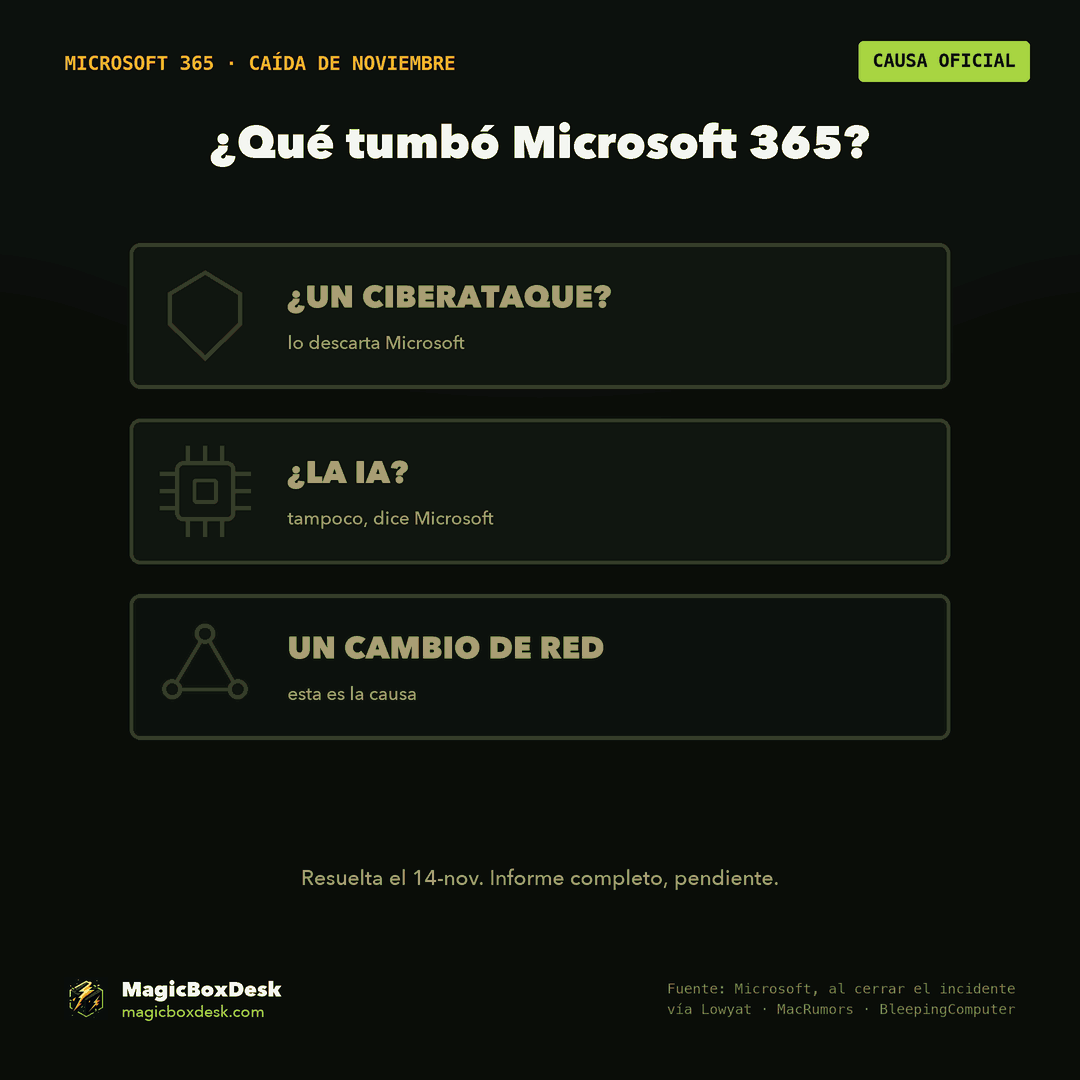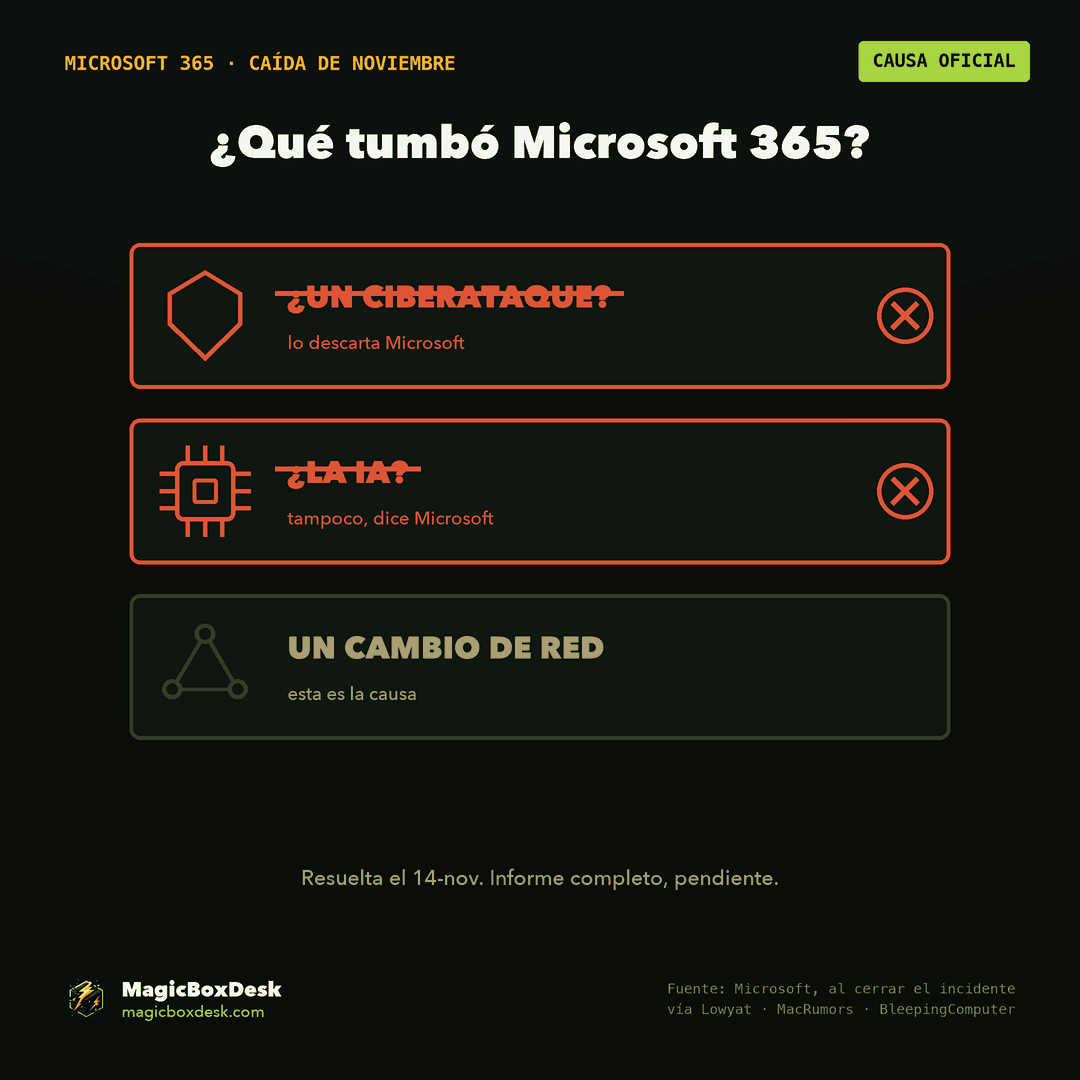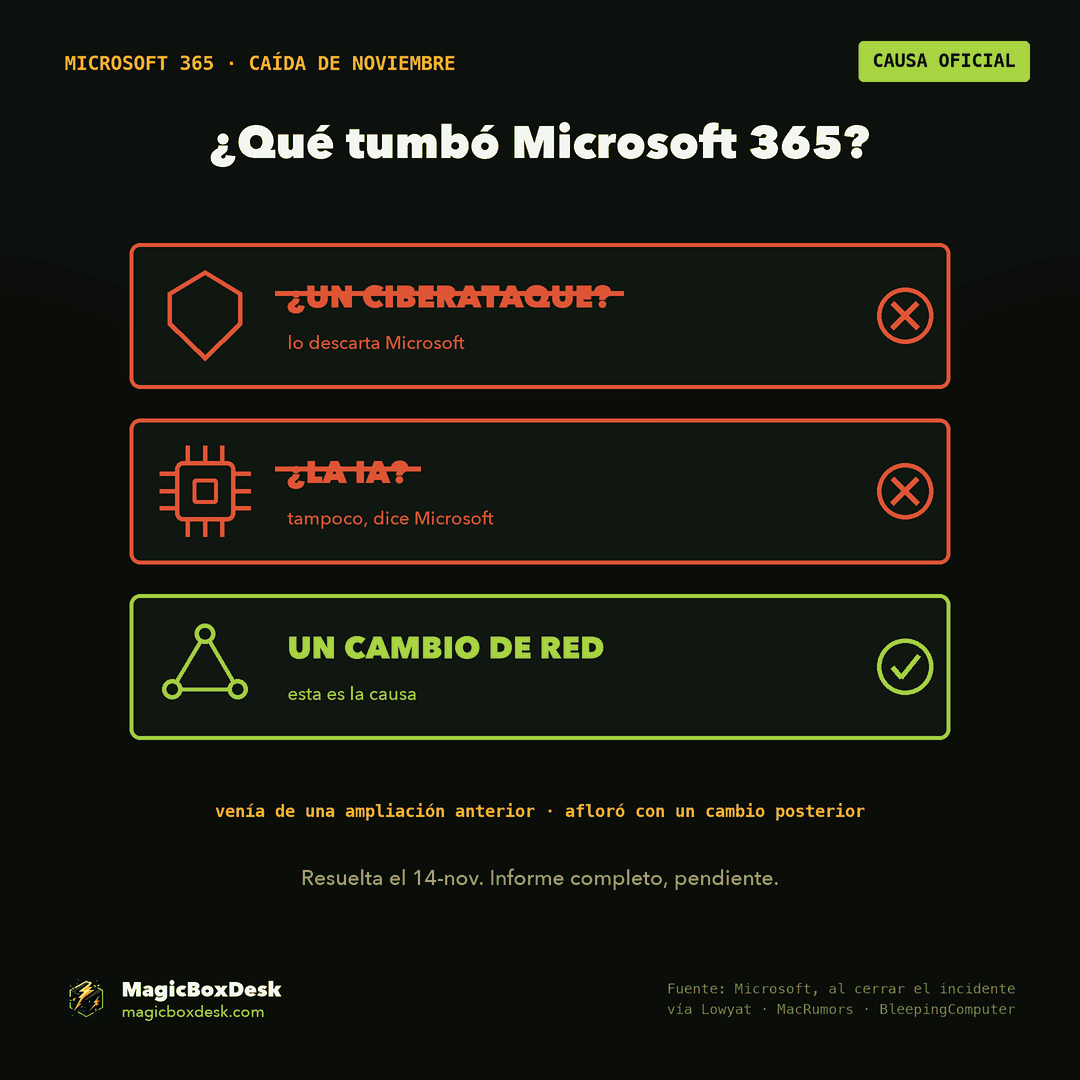
Durante dos días medio mundo se quedó sin Outlook, Teams y Microsoft 365, y la pregunta que no paraba de repetirse era si nos habían atacado. Microsoft ya ha cerrado el incidente y ha dicho qué pasó: no fue un ciberataque, y tampoco tuvo nada que ver con la IA. Fue un problema que venía de un cambio anterior en su red y que no dio la cara hasta que tocaron esa red otra vez. Esa frase, que parece burocrática, es justo la parte que deberías leer con atención: es la forma más común de romper un sistema que funcionaba.
Lo que ha confirmado Microsoft
La caída empezó el jueves 12 de noviembre sobre las 16:17 UTC y se cerró el sábado 14, después de más de un día de interrupción. Al darla por terminada, Microsoft dijo que había «completado el trabajo sobre el problema de fondo y restaurado el servicio a los clientes que quedaban afectados».
Y sobre la causa, lo importante, en sus propias palabras: el problema «venía de una ampliación de capacidad de red anterior y solo afloró tras un cambio de red más reciente».
Traducido: hace un tiempo se amplió la capacidad de la red y ahí quedó algo mal. No rompió nada ese día. Se quedó dormido. Hasta que semanas o meses después otro cambio en la red tocó esa pieza y entonces sí, todo a la vez, en medio planeta.
Lo que NO fue
Conviene dejarlo escrito, porque durante dos días circuló de todo:
- No fue un ciberataque. Microsoft lo ha descartado expresamente, igual que venía diciendo durante el incidente.
- No fue «culpa de la IA». También lo ha descartado de forma explícita: ni la IA ni los agentes autónomos tuvieron parte en esto. Lo aclara porque hoy es la primera sospecha de mucha gente, no porque hubiera indicios.
- No se perdió nada. Fue un problema de acceso, no de pérdida de datos.
⚠️ Y el matiz honesto: el informe post-incidente completo todavía no está publicado. Lo que hay hoy es la explicación con la que Microsoft cerró el incidente. El detalle fino —qué se tocó exactamente, por qué los controles no lo pillaron— llegará en ese informe, y puede matizar lo de arriba.
La parte que de verdad te interesa: el fallo que estaba dormido
Aquí está lo que separa esta noticia de un titular más.
El instinto, cuando algo se rompe, es mirar lo último que se tocó. Y casi siempre acierta. Pero este caso es el otro: lo que rompió el servicio no fue el cambio que lo activó, sino uno anterior que llevaba tiempo ahí, sin dar síntomas.
Eso tiene tres consecuencias muy concretas, y valen igual para una multinacional que para una empresa de veinte personas:
- «Funcionó» no es lo mismo que «está bien». Un cambio que no rompe nada el día que se aplica puede estar dejando el sistema en un estado frágil. La prueba de humo de después del cambio comprueba que las cosas van, no que el diseño sea sólido.
- Cuanto más tiempo pasa, más caro es encontrarlo. Cuando el fallo aparece meses después, nadie relaciona la avería de hoy con el cambio de entonces. Se buscan horas en el sitio equivocado. Por eso importa tanto dejar registrado qué se cambió y cuándo: un historial de cambios aburrido es lo que convierte ocho horas de búsqueda en veinte minutos.
- Los cambios en la red son los que más lejos llegan. Un fallo en una aplicación tumba esa aplicación. Un fallo en la red tumba todo lo que pasa por ella. Por eso un mismo error tiene un radio de daño tan distinto según dónde caiga.
Y la lección incómoda, otra vez
La de siempre, pero esta vez con factura: si todo tu correo, tus reuniones y tus ficheros viven en la nube de un único proveedor, su mal día es tu mal día. No hay parche que aplicar ni proveedor que cambiar; hay que tener previsto el día que no está.
Lo mínimo razonable, y no cuesta dinero:
- Un canal alternativo para avisar a tu equipo y a tus clientes cuando el correo no va (teléfono, WhatsApp, un grupo de Telegram… lo que uséis, pero decidido antes).
- Saber dónde mirar el estado real: el parte oficial del proveedor, no las redes sociales.
- No reenviar ni reintentar en masa durante una caída: alarga el atasco para todos.
- Una copia de lo crítico fuera de ese proveedor. No por el ataque: por el martes que no va.
Qué hacemos con esto
Si durante esos dos días estuviste sin saber qué decirle a tus clientes, sin poder confirmar si era tuyo o de Microsoft, y mandando correos que no salían, eso no se arregla con tecnología: se arregla teniéndolo escrito antes. En MagicBoxDesk lo dejamos montado y probado —plan de comunicación alternativo, vigilancia del estado de los servicios y copias fuera del proveedor—, para que el próximo mal día de la nube sea un rato incómodo y no un día perdido.
Fuentes
Todo lo que se afirma aquí sale de estas fuentes.
- Lowyat — Microsoft da la caída por totalmente resuelta y explica el origen (14-nov-2026)
- MacRumors — la recuperación, tras casi 24 horas
- Cointelegraph — caída resuelta y ciberataque descartado
- BleepingComputer — la caída masiva de Microsoft 365: Outlook, Teams y Copilot
- Microsoft 365 Status (@MSFT365Status) — el parte oficial durante el incidente
De la misma serie
- Microsoft caído en medio mundo: no es un ciberataque (lo que contamos durante el incidente)
- SignDrop: el blindaje de Windows convertido en la llave de SYSTEM
- El perímetro es la puerta: por qué entran por tu firewall y tu VPN
¿Tienes previsto el día que tu proveedor de nube no está? En MagicBoxDesk lo dejamos montado y probado: ciberseguridad y puesto de trabajo gestionados. 📍 Alicante y Barcelona · hablemos 30 minutos.